← Grįžti į projektus

Produkcinis projektas

Voice Translator

Produkcinis RU ↔ EN push-to-talk balso vertėjas, iš paprasto kalbos apdorojimo pipeline išaugęs į benchmarkais pagrįstą inžinerinę laboratoriją.

Tipas

Balso vertimo sistema

Pagrindinis dėmesys

Kalbos pipeline, benchmarkai ir realaus laiko perdavimas

Būsena

v1.0.0

01 / Projektas

Projektas

Pradinė idėja buvo sąmoningai paprasta: paspausti mygtuką, pasakyti frazę rusiškai ir išgirsti ją anglų kalba. Tada tą patį atlikti priešinga kryptimi.

Kai bazinis speech-to-text → translation → text-to-speech pipeline jau veikė, sudėtingiausias klausimas pasikeitė. Reikėjo nebe išsiaiškinti, ar balso vertimą galima sujungti, o nustatyti, kuri technologija yra pakankamai tiksli ir greita praktiškam beveik realaus laiko pokalbiui.

Šis klausimas projektą iš funkcionalumo kūrimo pavertė R&D užduotimi su kontroliuojamais garso įrašais, keliais kalbos atpažinimo tiekėjais, pakartojamais benchmarkais, naršyklės laiko matavimais ir galiausiai produkciniu demo.
Lūžio taškas

Katinas, nuo kurio prasidėjo R&D skyrius

Vienas svarbiausių testų buvo susijęs su mano katinu Persiku. Rusišką frazę „Кот Персик рыжий хулиган“ Google atpažino kaip „Код Персик рыжий хулиган“. Klaida buvo visiškai logiška: rusų kalboje žodžių „кот“ ir „код“ galiniai priebalsiai be pakankamo konteksto gali skambėti beveik vienodai.

Pridėjus daugiau konteksto atpažinimas tapo teisingas. Šis nedidelis eksperimentas pakeitė projekto kryptį: vietoje klausimo, ar kalbos atpažinimas apskritai veikia, pradėjau tirti, kuri speech technologija iš tikrųjų yra pakankamai gera beveik realaus laiko RU ↔ EN komunikacijai.

Pirmasis testas

Кот Персик рыжий хулиган.

↓

Код Персик рыжий хулиган.

Su daugiau konteksto

У меня есть кот Персик, он рыжий хулиган.

Atpažinta teisingai

Vėliau pipeline

Персик

↓

Peach

Persikas parodė du skirtingus klaidų tipus: kalbos atpažinimas gali neteisingai suprasti žodį, o net teisinga transkripcija vis tiek gali būti išversta klaidingai. Todėl projektas galiausiai pradėjo vertinti visą pipeline, o ne pasitikėti vienu sėkmingu API atsakymu.

02 / Produkcinis pipeline

Nuo kalbos iki išversto balso

Produkcinis procesas padalintas į išmatuojamus etapus, kad kalbos atpažinimą, vertimą, balso sintezę ir rezultatų perdavimą būtų galima vertinti atskirai.

01 / Įvestis

Push-to-talk įrašymas

Naršyklė įrašo trumpą WebM garso fragmentą. Aiškūs Start ir Stop veiksmai išlaiko pokalbio modelį nuspėjamą ir leidžia koncentruotis į patikimą vertimą, neapsimetant, kad sistema jau teikia pilną simultaneous interpretation.

02 / Speech-to-text

Streaming kalbos atpažinimas

Rusų ir anglų kalboms naudojami atskirai pagal benchmarkų rezultatus parinkti Google Chirp 3 streaming profiliai, vietoje vienos universalios konfigūracijos abiem kalboms.

03 / Vertimas

DeepL vertimas

Atpažintas tekstas verčiamas tarp rusų ir anglų kalbų. Vertimo etapas buvo benchmarkinamas atskirai, nes teisinga transkripcija dar negarantuoja teisingos prasmės.

04 / Balso rezultatas

OpenAI streaming TTS

Išverstas tekstas paverčiamas garsu ir grąžinamas naršyklei, kur reali playback pradžia tampa vartotojo jaučiamos delsos matavimo dalimi.

Pasirinkti produkciniai profiliai

Rusų kalbos įvestis → Chirp 3 Streaming STANDARD → DeepL → OpenAI TTS. Anglų kalbos įvestis → Chirp 3 Streaming SHORT → DeepL → OpenAI TTS.

03 / Inžinerinė laboratorija

Nuo CLI benchmarkų iki naršyklės laboratorijos

Benchmarkai prasidėjo kaip command-line įrankiai ir išaugo į naršyklėje veikiančią Live Pipeline Lab, kurioje tą patį įrašą galima paleisti per kelis pilnus profilius.

Kontroliuojama įvestis

Vienas įrašas, keli modeliai

Tas pats WebM garso įrašas gali būti pakartotinai naudojamas skirtingiems profiliams, todėl rezultatai nepriklauso nuo to, kaip žmogus pakartotinai ištarė tą pačią frazę.

Profiliai

Skirtingos pipeline strategijos

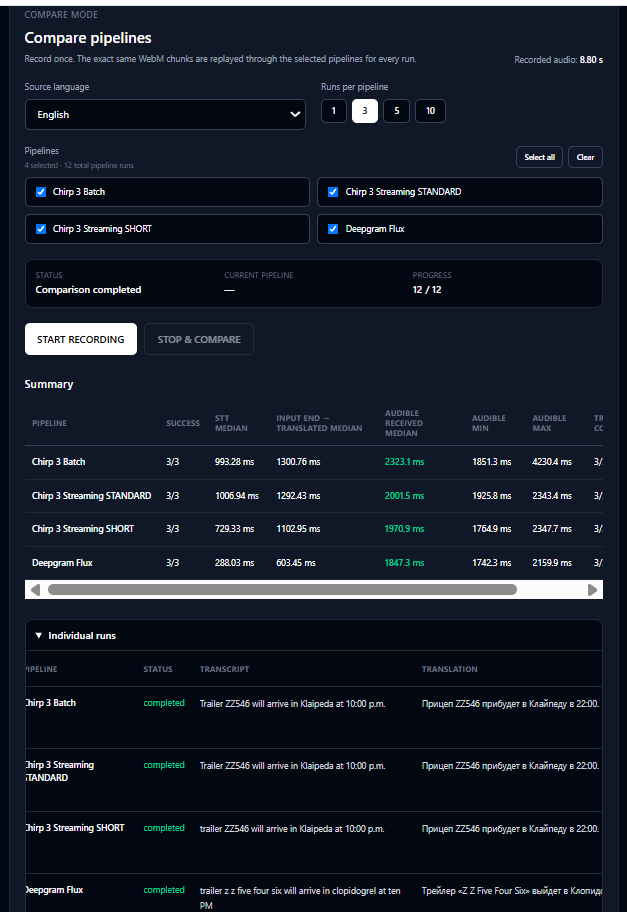
Batch Chirp 3, Streaming STANDARD, Streaming SHORT ir Deepgram Flux gali būti lyginami naudojant tuos pačius vertimo ir TTS etapus.

Matavimai

Etapų ir end-to-end laikas

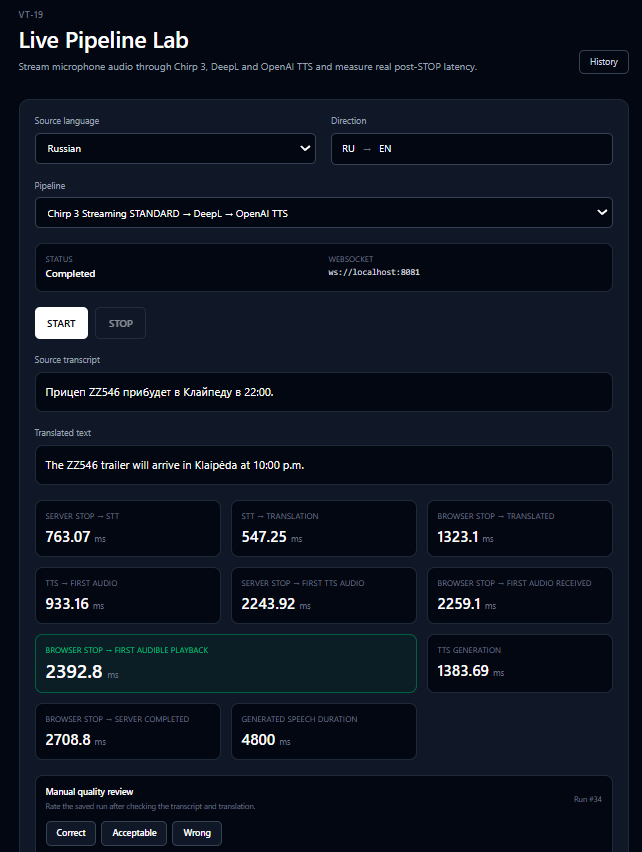
Lab matuoja STT, vertimo, TTS, audio-ready ir naršyklės playback laiką, todėl visas vartotojo potyris nėra redukuojamas iki vieno provider request.

Išsaugojimas

Run rezultatai išlieka

Transkripcijos, vertimai, laiko matavimai, kokybės žymos ir ankstesni run rezultatai saugomi vėlesnei analizei bei profilių palyginimui.

Voice Translator inžinerinė laboratorija su užbaigtu pipeline run, transkripcija, vertimu ir laiko metrikomis.

04 / Benchmarkai

Matuoti prasmę, o ne tik žodžius

Benchmarkuose naudoti kontroliuojami garso įrašai su logistikos frazėmis, o kokybė vertinta pagal kritinių elementų išsaugojimą. Pamesti artikelį nėra tas pats, kas 15 paversti į 50, pakeisti vilkiko numerį, paskirties vietą, temperatūrą ar operacinę instrukciją.

Geriausia išmatuota RU kokybė

93.33%

RU STANDARD STOP → audio

1701 ms

EN SHORT STOP → audio

1677 ms

Profilis RU kokybė EN kokybė RU STOP → audio EN STOP → audio
Batch Chirp 3 93.33% 90.63% 2104 ms 1982 ms
Streaming STANDARD 93.33% 90.63% 1701 ms 1850 ms
Streaming SHORT 90.00% 90.63% 1315 ms 1677 ms
Deepgram Flux 86.67% 78.13% 1236 ms 1279 ms

Inžinerinis sprendimas

Rusų kalbai paliktas Streaming STANDARD, nes jis išlaikė geriausią išmatuotą 93.33% kokybę ir kartu sumažino delsą lyginant su batch atpažinimu. Anglų kalbai pasirinktas Streaming SHORT, nes jis išlaikė tokią pačią 90.63% kokybę kaip STANDARD, tačiau sumažino tiek atpažinimo, tiek visą STOP-to-audio delsą.

Voice Translator Lab palyginimas su kelių kalbos atpažinimo profilių kokybės ir delsos rezultatais.

05 / Viešas demo

Lab yra lanksti. Internetas nėra.

Vieša sąsaja naudoja tikrą vertimo pipeline, tačiau sąmoningai pašalina didžiąją dalį eksperimentinių pasirinkimų. Patikimą pipeline konfigūraciją valdo serveris, o ne naršyklė.

Sesija

Trumpalaikis vienkartinis token

Prieš atidarant WebSocket pipeline naršyklė paprašo trumpalaikės demo sesijos. Backend patikrina šaltinio kalbą, parenka sukonfigūruotą profilį, rezervuoja kvotą ir išduoda vienkartinį token.

Ribojimai

15 sekundžių vieši įrašai

Serveris riboja įrašo trukmę ir garso dydį bei taiko lankytojo, IP ir globalias kvotas, kad demo netaptų neribotu speech API proxy.

Pasitikėjimo riba

Serverio parenkamas pipeline

Vieši klientai negali savavališkai pasirinkti provider, eksperimentinių profilių ar patikimos source konfigūracijos. Šie sprendimai lieka serverio pusėje.

Valdymas

Kill switch ir privati Lab

Viešą demo galima išjungti nepriklausomai, o eksperimentinė Live Lab produkcijoje išlieka atskirai apsaugota nuo viešos prieigos.

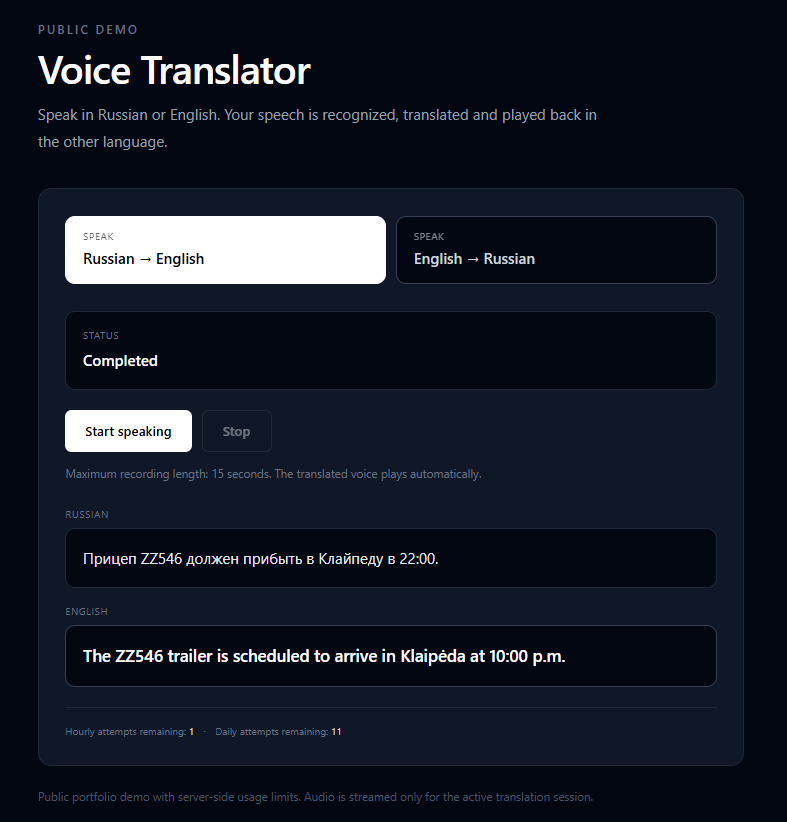
Voice Translator desktop sąsaja su rusų ir anglų push-to-talk vertimo valdikliais.
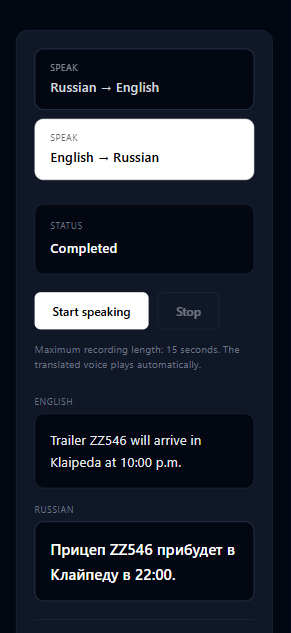
Voice Translator mobili sąsaja.

06 / Produkcija ir diegimas

Production yra visai kita rūšis

Kai pipeline ir Lab pradėjo patikimai veikti lokaliai, projektas buvo išdiegtas kaip atskiros produkcinės paslaugos, o ne paliktas kaip įspūdinga terminalų langų kolekcija.

Hostingas

Railway deployment

Produkcinė sistema veikia Railway su atskiromis Laravel web aplikacijos, WebSocket pipeline serverio ir MySQL paslaugomis.

Realtime

Atskiras WebSocket pipeline

WebSocket servisas apdoroja live audio nepriklausomai nuo įprastų web užklausų ir viešų demo sesijų kūrimo.

Runtime

Kalbos apdorojimui paruoštas PHP container

Produkcinėje PHP 8.4 aplinkoje įdiegtos speech stack reikalingos priklausomybės, įskaitant gRPC, protobuf, intl, pcntl ir MySQL palaikymą.

Prisijungimo duomenys

Cloud aplinkai pritaikytos paslaptys

Provider paslaptys laikomos environment konfigūracijoje. Google service-account credentials produkcijoje gali būti pateikiami kaip JSON, todėl nereikia lokaliai mountinamo failo.

Domenas

voice.kotov.lt

Viešas RU ↔ EN demo pasiekiamas per atskirą HTTPS produkcinį subdomeną.

Kokybė

Automatizuota projekto patikra

Prieš release projektas tikrinamas testais, PHPStan, Laravel Pint ir frontend production build.

Produkcinė aplinka

Laravel, Railway, MySQL, atskiras WebSocket servisas, Google Speech-to-Text, DeepL, OpenAI TTS, HTTPS ir nuosavas domenas.

07 / Dabartiniai apribojimai

Ko v1.0.0 neapsimeta jau išsprendusi

Projektas aiškiai parodo dabartines ribas ir nevadina push-to-talk produkcinio demo baigta simultaneous interpretation sistema.

Komunikacija veikia push-to-talk principu, o ne kaip full-duplex simultaneous translation.

Dabartinis viešas demo orientuotas į RU ↔ EN; lietuvių kalba lieka būsimu plėtros etapu.

Kokybė ir delsa vis dar priklauso nuo tinklo sąlygų bei išorinių cloud provider.

Išversto balso perdavimas tiesiogiai tarp dviejų atskirų kompiuterių arba į konferencijų programas lieka būsimu darbu už dabartinio portfolio demo ribų.

08 / Technologijos

Technologijų stack

Projektas jungia Laravel aplikaciją, naršyklės audio įrašymą, realaus laiko komunikaciją, išsaugomus benchmark duomenis ir specializuotus speech bei language provider.

Aplikacija

PHP 8.4

Laravel 13

Blade

Vite

Kalba ir vertimas

Google Speech-to-Text

DeepL

OpenAI TTS

WebM audio

Duomenys ir realtime

MySQL

WebSockets

Persisted Lab runs

Browser timing metrics

Inžinerija

Docker

Laravel Sail

PHPStan

Laravel Pint

CI

09 / Rezultatas

Ką parodo šis projektas

Voice Translator parodo daugiau nei kelių AI API sujungimą. Projekte naudojami kontroliuojami garso įrašai, kritinių elementų išsaugojimo vertinimas ir end-to-end laiko matavimai, kad būtų galima nustatyti, kaip skirtingi pipeline sprendimai veikia tiek tikslumą, tiek vartotojo realiai jaučiamą delsą.

Projektas taip pat parodo kelią nuo netikėtos kalbos atpažinimo problemos su katinu iki pakartojamo R&D proceso, naršyklėje veikiančios inžinerinės Lab ir galiausiai valdomos produkcinės aplikacijos su aiškiomis pasitikėjimo ribomis bei viešo naudojimo apsaugomis.

Streaming kalbos apdorojimas

Kontroliuojama benchmark metodika

Kritinių elementų išsaugojimas

End-to-end delsos matavimas

Provider ir pipeline palyginimas

Production deployment ir apsaugos