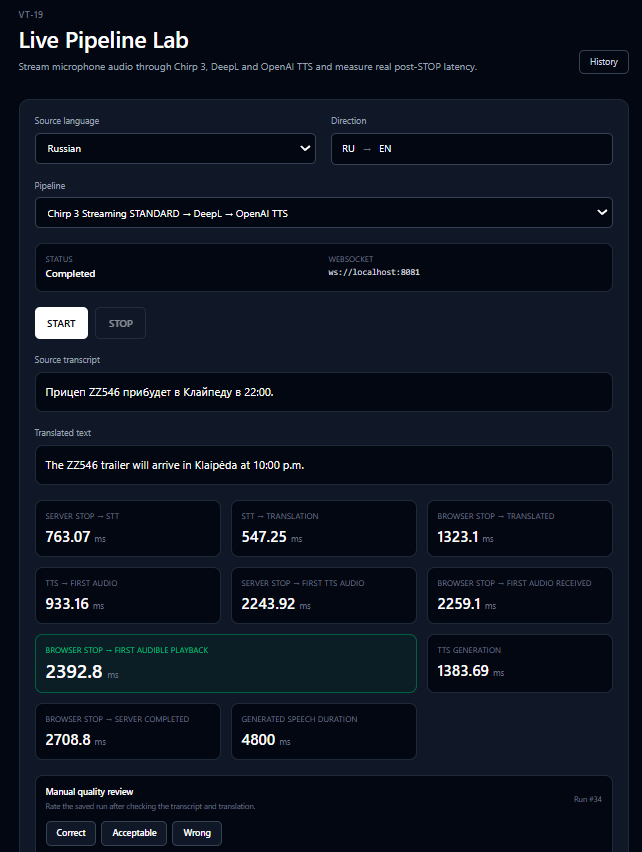
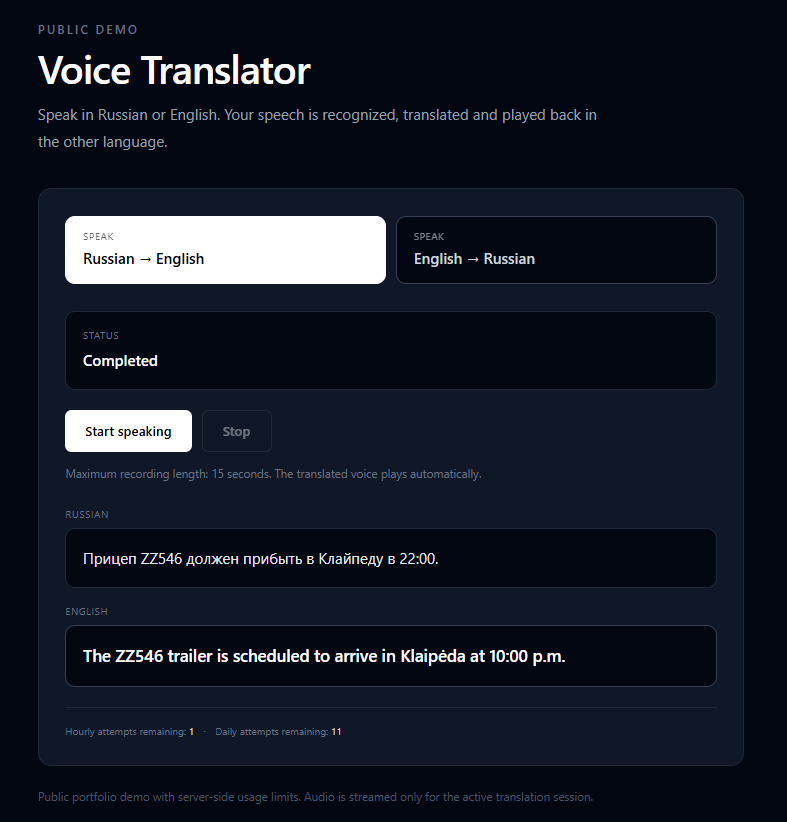
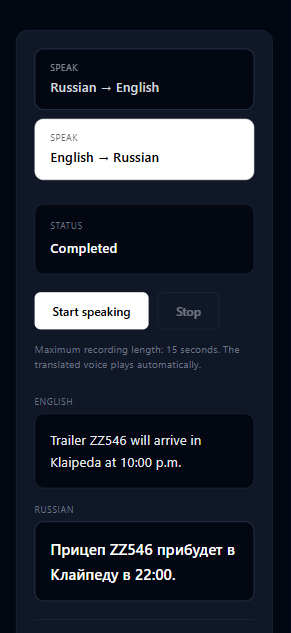
Изначальная идея была намеренно простой: нажать кнопку, сказать фразу на русском и услышать её на английском. Затем сделать то же самое в обратном направлении.
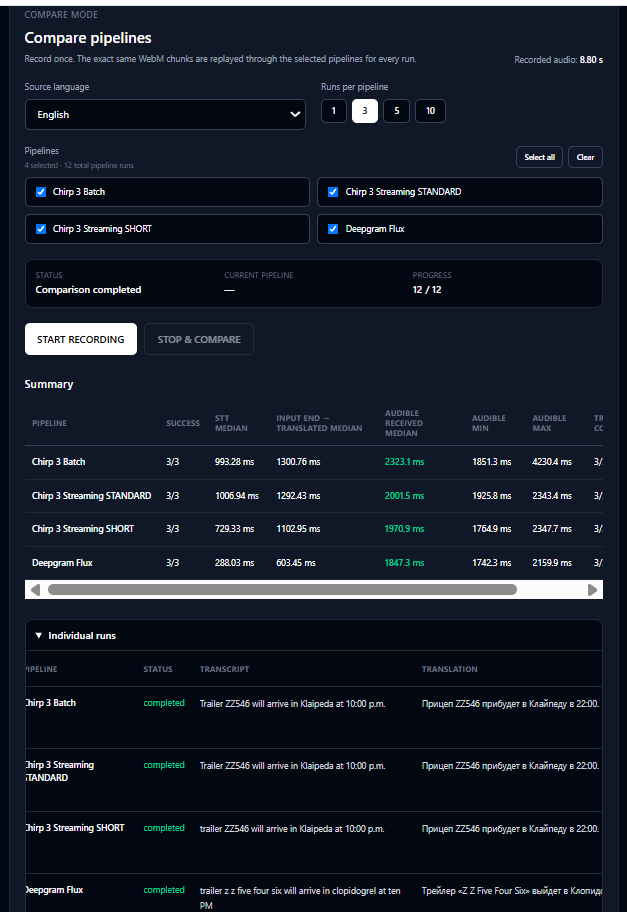
Когда базовый pipeline speech-to-text → translation → text-to-speech уже заработал, главный вопрос изменился. Нужно было понять не то, можно ли вообще собрать голосовой перевод, а какая технология достаточно точна и быстра для практического общения почти в реальном времени.
Этот вопрос превратил разработку функциональности в R&D-задачу с контролируемыми аудиозаписями, несколькими speech-провайдерами, повторяемыми benchmark-тестами, измерениями в браузере и в итоге production demo.